
利用場面
本番アプリでのコードレビュー
例:プルリクエストで認証ミドルウェアが変わります。 レビューサービスが差分、近くの関数、安全規約、変更行の対応表をcodex-auto-reviewに送ります。 具体的にどう失敗するかを示す問題だけを返す必要があります。
ファイル、変更行、重大度、根拠、修正案が揃わないコメントは除外します。 問題のないPRもテストに含めます。コメントが多いほど優れたレビューとは判定しません。
本番用の用途例
例:プルリクエストで認証ミドルウェアが変わります。 レビューサービスが差分、近くの関数、安全規約、変更行の対応表をcodex-auto-reviewに送ります。 具体的にどう失敗するかを示す問題だけを返す必要があります。
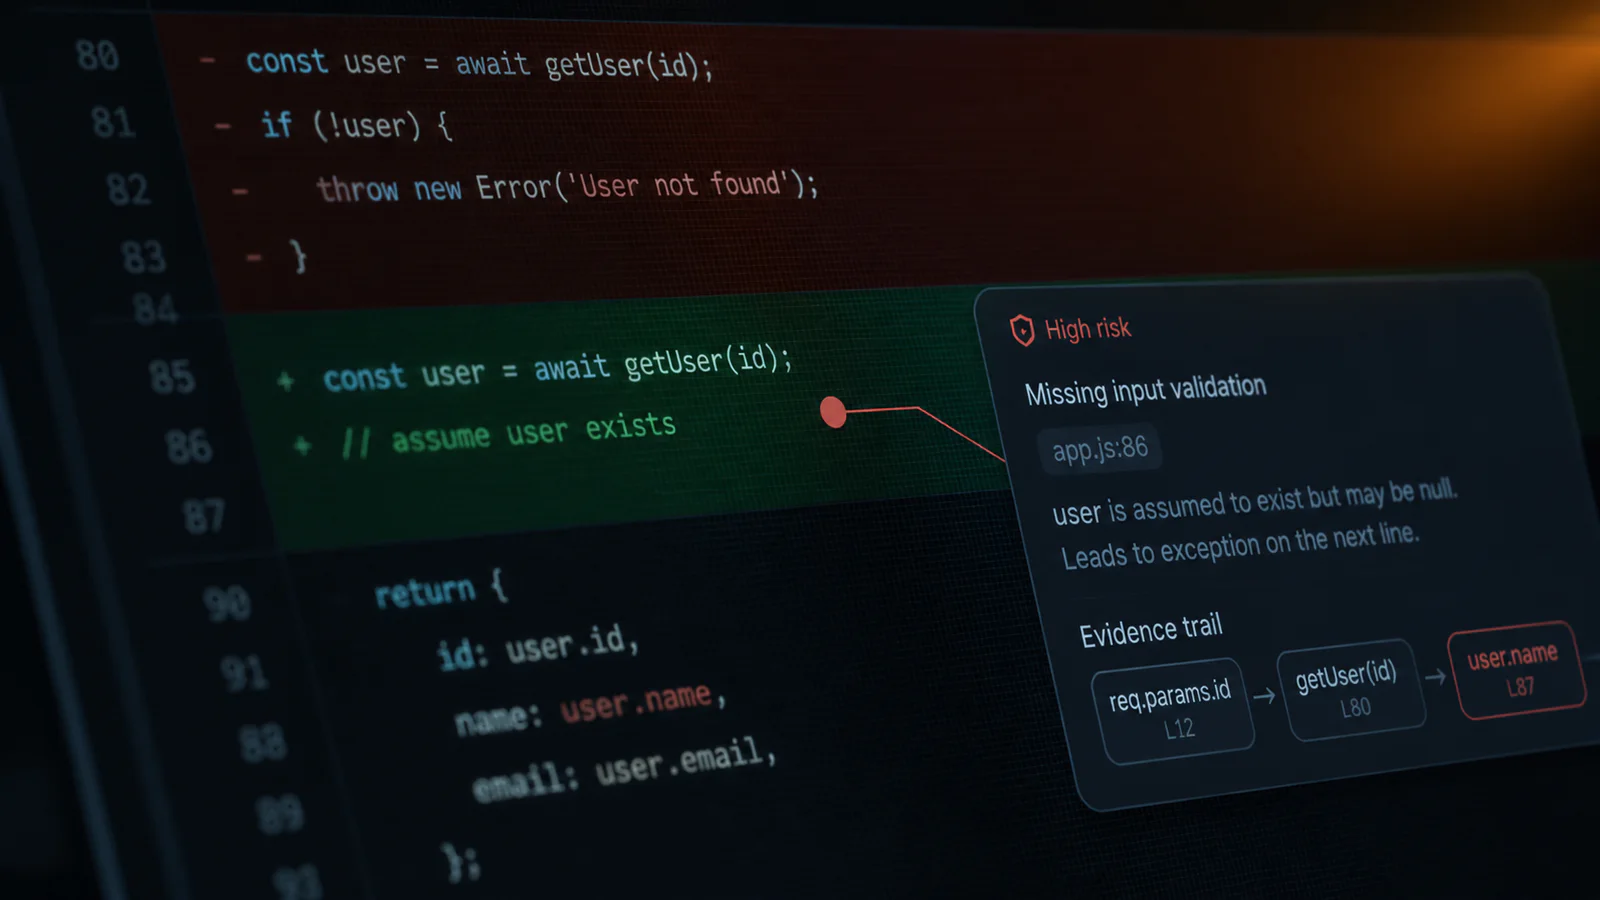
本番用の実装例
| 本番向けの選択 | 推奨 | 理由 |
|---|---|---|
| API | POST /v1/chat/completions | OpenAI互換のサーバー側リクエスト |
| 主モデル | codex-auto-review | codex-auto-reviewは現在モデル一覧で提供している、自動レビュー専用の最初の候補です。 |
| 代替モデル | gpt-5.6-terra | 広いリポジトリの理解が必要ならTerra。議論が分かれる高リスクの問題はSolへ回し、通常のPRをすべてSolへ送らないでください。 |
| 難しい作業の上位モデル | gpt-5.6-sol | 主モデルが品質・複雑さの基準を満たせない場合だけ使う |
| 出力仕様 | 検証済みJSON | JSONの問題情報:ファイル、行、重大度、見出し、根拠、失敗する経路、修正案。 |
例:プルリクエストで認証ミドルウェアが変わります。 レビューサービスが差分、近くの関数、安全規約、変更行の対応表をcodex-auto-reviewに送ります。 具体的にどう失敗するかを示す問題だけを返す必要があります。
ファイル、変更行、重大度、根拠、修正案が揃わないコメントは除外します。 問題のないPRもテストに含めます。コメントが多いほど優れたレビューとは判定しません。
リクエストはサーバーから送ります。例の内容と仮のツールスキーマを、アプリのデータとツールに置き換えてください。
curl https://app.llmfly.ai/v1/chat/completions \
  -H "Authorization: Bearer $LLMFLY_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "codex-auto-review",
    "messages": [
      {"role": "system", "content": "Review the supplied diff. Report only actionable defects introduced by this change. Each finding needs file, changed line, severity, failure path, evidence, and a minimal fix."},
      {"role": "user", "content": "Review this authentication middleware pull request against the attached repository rules."}
    ],
    "response_format": {"type": "json_object"}
}'codex-auto-reviewは現在モデル一覧で提供している、自動レビュー専用の最初の候補です。
広いリポジトリの理解が必要ならTerra。議論が分かれる高リスクの問題はSolへ回し、通常のPRをすべてSolへ送らないでください。
| 測定項目 | 合格条件 |
|---|---|
| 実際の問題を見つける率 | テストに埋め込んだ高リスクの問題を発見できる |
| 誤検出率 | 問題のない比較用変更に、不要なブロックや架空の指摘がない |
| 行単位の根拠 | 各問題が最小の関連行と、失敗する経路を示す |
| レビュアーの採用率 | 適任のレビュアーが、正しく修正可能で表示する価値があると判断する |
JSONの問題情報:ファイル、行、重大度、見出し、根拠、失敗する経路、修正案。
本番の実行ごとにモデルID、リクエストID、トークン使用量、再試行、検証結果、最終的な扱いを記録してください。
問題のない変更を含め、適任のレビュアーが誤りや修正不能と判定した指摘を数えます。
常に必要とは限りません。 まず差分と直接関係するファイルを使い、必要なら情報を追加します。
ファイル、行、重大度、説明、根拠、修正案を含むスキーマを使います。
同じリクエスト、ツール、検証ルールで主モデルと代替モデルを比較します。